
 NEW
프런트엔드 성능 최적화 Deep Dive (ebook)
52,000원
중급
NEW
프로그래밍 & 프랙티스
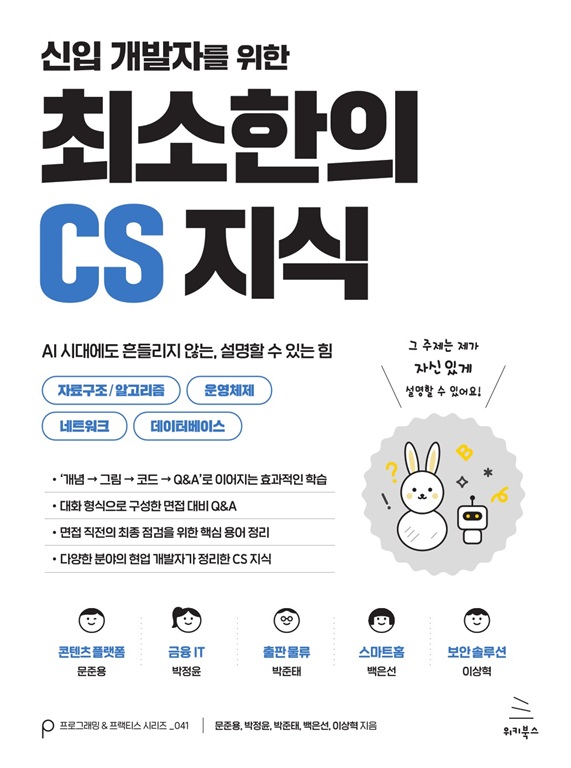
신입 개발자를 위한 최소한의 CS 지식
AI 시대에도 반드시 갖춰야 할 CS 기초의 모든 것
지은이 문준용, 박정윤, 박준태, 백은선, 이상혁
도서 정보
- 출간일
- 2026년 10월 14일
- 쪽수
- 464쪽
- 판형
- 175*235*19mm
- ISBN
- 9791158397005
- 시리즈
- 프로그래밍 & 프랙티스_041
- 정가
- 21,600원
- 난이도
-
입문 초급 중급 고급
도서 소개
저자 소개
목차
도서 소개
기술 면접에서 막히는 건, 몰라서가 아니라 설명하지 못해서입니다!
합격을 결정하는 것은 얼마나 많이 아느냐가 아니라, 꼬리 질문 앞에서 끊기지 않고 논리를 이어갈 수 있느냐입니다. 예상 질문과 답변을 외우는 방식으로는 그 힘이 생기지 않습니다. 개념이 서로 어떻게 연결되는지 모른 채 쌓은 지식은 예상 밖의 질문 하나에 바로 막힙니다.
이 책은 다섯 명의 개발자가 직접 취업을 준비하며 깃허브에 쌓아온 CS 스터디 노트에서 시작했습니다. 실제로 막혔던 질문, 헷갈렸던 개념, 면접이 끝난 뒤 다시 짚어본 흐름이 그대로 담겨 있습니다. 자료구조와 알고리즘, 운영체제, 네트워크, 데이터베이스의 핵심 개념을 면접에서 질문이 이어지는 순서에 맞춰 구성했고, 개념마다 ‘면접 포인트’를 두어 개념을 이해하는 데서 실제 답변까지 한 흐름으로 이어지게 했습니다. “TCP와 UDP의 차이는?” 같은 질문에 한 줄로 답하고 끝나는 게 아니라 “그럼 왜 굳이 연결을 먼저 설정하나요?” 같은 꼬리 질문까지 이어서 답할 수 있도록 연습합니다.
★ 이 책에서 다루는 내용 ★
- 자료구조와 알고리즘: 배열, 연결 리스트, 스택, 큐, 트리, 그래프, 정렬, 탐색
- 운영체제: 프로세스, 스레드, 메모리 관리, 동기화, 데드락
- 네트워크: OSI 모델, TCP/UDP, HTTP, DNS, 쿠키와 세션
- 데이터베이스: 정규화, 인덱스, 트랜잭션, 조인
도서 소개

저자 소개
문준용
경북대학교 컴퓨터학부 글로벌소프트웨어융합전공을 졸업했다. 현재는 창작 커뮤니티 포스타입에서 소프트웨어 엔지니어로 일하고 있으며, 사용자가 실제로 즐거워하는 제품을 만드는 일에 관심이 많다. 이 책에서는 운영체제 파트를 맡았다.
박정윤
산업공학을 전공하고 비전공자 출신으로 현재 금융권 IT 회사에서 뱅킹 앱 개발자로 근무하고 있다. 이 책에서는 네트워크, 운영체제 파트를 맡았다.
박준태
전자정보통신을 전공하고 모터제어 하드웨어 개발자에서 백엔드 개발자로 직무전환했다. 출판물류회사에서 백엔드 엔지니어로 근무하며 이 책에서는 데이터베이스 파트를 맡았다.
백은선
컴퓨터과학과 산업공학을 전공했으며, 현재 스마트홈 플랫폼의 백엔드 개발자로 재직 중이다. 마이크로서비스 아키텍처 환경에서 인증, 회원, 디바이스 연동 도메인을 주로 다루고 있다. 이 책에서는 네트워크와 알고리즘 파트를 맡았다.
이상혁
컴퓨터학과를 전공했으며, 현재 보안 솔루션 회사에서 계정 관리 시스템 개발을 담당하는 백엔드 개발자로 재직 중이다. 보안과 백엔드 시스템 개발 경험을 바탕으로 이 책에서는 자료구조 및 알고리즘 파트를 맡았다.
목차
- [01부] 자료구조와 알고리즘
- ▣ 01장: 시간 복잡도와 공간 복잡도
- 1.1 _ 복잡도
- __1.1.1 시간 복잡도는 무엇인가요?
- __1.1.2 공간 복잡도는 무엇인가요?
- __1.1.3 점근적 표기법을 설명해 주세요
- __1.1.4 시간 복잡도 계산은 어떻게 하나요?
- __1.1.5 공간 복잡도 계산은 어떻게 하나요?
- __1.1.6 시간 복잡도 유형은 무엇이 있나요?
- ▣ 02장: 선형 자료구조
- 2.1 _ 배열
- __2.1.1 배열의 메모리 구조와 인덱싱
- __2.1.2 배열의 시간 복잡도
- __2.1.3 배열의 확장: 다차원 배열
- __2.1.4 배열의 한계와 동적 배열
- 2.2 _ 리스트
- __2.2.1 ArrayList란 무엇인가요?
- __2.2.2 ArrayList 주요 연산 시간 복잡도를 설명해 주세요
- __2.2.3 배열과 ArrayList 차이점은 무엇인가요?
- __2.2.4 연결 리스트(Linked List)란 무엇인가요?
- __2.2.5 LinkedList 주요 연산 시간 복잡도를 설명해 주세요
- __2.2.6 ArrayList와 LinkedList 중 무엇을 선택해야 하나요?
- 2.3 _ 스택
- __2.3.1 스택의 주요 연산은 무엇이 있나요?
- __2.3.2 스택 메모리는 JVM 메모리 구조에서 어떤 역할을 할까요?
- __2.3.3 스택은 어떻게 구현할 수 있나요?
- 2.4 _ 큐
- __2.4.1 큐의 구조와 작동에 대해 설명해 주세요
- __2.4.2 큐의 주요 연산은 무엇이 있나요?
- __2.4.3 큐는 어떻게 구현할 수 있나요?
- __2.4.4 우선순위 큐에 관해 설명해 주세요
- __2.4.5 큐와 스택의 차이점에 대해 설명해 주세요
- ▣ 03장: 비선형 자료구조
- 3.1 _ 트리
- __3.1.1 선형 구조보다 트리가 유리한 상황은 언제인가요?
- __3.1.2 트리를 이루는 주요 용어들에 관해 설명해 주세요
- __3.1.3 깊이와 높이의 차이는 무엇인가요?
- __3.1.4 이진 트리란 무엇인가요?
- __3.1.5 이진 트리의 순회 방식은 어떤 게 있나요?
- __3.1.6 이진 탐색 트리란 무엇인가요?
- 3.2 _ 그래프
- __3.2.1 그래프는 어떤 자료구조인가요?
- __3.2.2 DFS와 BFS는 어떻게 다른가요?
- __3.2.3 다익스트라 알고리즘은 어떤 원리로 작동하나요?
- __3.2.4 음수 간선이 있다면 어떻게 최단 거리를 구하나요?
- __3.2.5 모든 지점 간 가장 짧은 경로를 한 번에 구할 수 있는 방법은 무엇인가요?
- __3.2.6 그래프 알고리즘은 언제 어떤 걸 선택해야 하나요?
- ▣ 04장: 정렬 알고리즘
- 4.1 _ 삽입 정렬
- __4.1.1 삽입 정렬의 시간 복잡도
- __4.1.2 삽입 정렬이 적합한 상황은 무엇이 있나요?
- 4.2 _ 퀵 정렬
- __4.2.1 퀵 정렬이 적합한 상황은 무엇이 있나요?
- 4.3 _ 병합 정렬
- __4.3.1 병합 정렬이 적합한 상황은 무엇이 있나요?
- ▣ 05장: 탐색·최적화 알고리즘
- 5.1 _ 해시
- __5.1.1 해시 함수란 무엇인가요?
- __5.1.2 HashMap이란 무엇인가요?
- __5.1.3 해시 충돌은 어떻게 해결하나요?
- __5.1.4 HashSet이란 무엇인가요?
- __5.1.5 HashMap과 HashSet의 공통점과 차이점을 설명해 주세요
- 5.2 _ 그리디 알고리즘
- __5.2.1 그리디 알고리즘은 어떤 문제에 적합할까요?
- __5.2.2 그리디 알고리즘은 언제 실패할까요?
- __5.2.3 그리디 알고리즘 구현 시 주의해야 할 점은 무엇인가요?
- __5.2.4 그리디 알고리즘은 언제 사용되나요?
- 5.3 _ 동적 계획법
- __5.3.1 동적 계획법은 어떤 문제에 효과적일까요?
- __5.3.2 그리디 알고리즘과 동적 계획법의 차이점은 무엇인가요?
- __5.3.3 동적 계획법의 두 가지 방식: 하향식과 상향식
- __5.3.4 구현 시 주의할 점은?
- [02부] 운영체제
- ▣ 06장: 프로세스와 스레드
- 6.1 _ 프로세스
- __6.1.1 프로세스란
- __6.1.2 프로세스 상태에 대해 설명해 주세요
- __6.1.3 프로세스 제어 블록(PCB)
- __6.1.4 fork() 시스템 콜의 작동 원리와 프로세스 생성 과정
- 6.2 _ 스레드
- __6.2.1 스레드란?
- __6.2.2 멀티 프로세스와 멀티 스레드의 차이에 대해 설명해 주세요
- __6.2.3 멀티 프로세스 대신 멀티 스레드를 사용하는 이유에 대해 설명해 주세요
- __6.2.4 멀티 스레드의 문제점
- 6.3 _ 핵심 용어 정리
- ▣ 07장: 동기화와 교착상태
- 7.1 _ 동기화란?
- __7.1.1 경쟁상태
- __7.1.2 공유 자원과 임계영역
- 7.2 _ 동기화 기법
- __7.2.1 뮤텍스란?
- __7.2.2 세마포어란?
- __7.2.3 모니터란?
- 7.3 _ 교착상태란?
- __7.3.1 교착상태 발생 조건에 대해 설명해 보세요
- __7.3.2 교착상태 해결 방법에 대해 설명해 주세요
- 7.4 _ 핵심 용어 정리
- ▣ 08장: 인터럽트와 시스템 콜
- 8.1 _ 인터럽트
- __8.1.1 인터럽트란 무엇인가요?
- __8.1.2 인터럽트가 필요한 이유가 무엇인가요?
- __8.1.3 인터럽트가 발생하면 어떤 일이 일어나는지 설명해 주세요
- __8.1.4 인터럽트 서비스 루틴(ISR)은 어떤 역할을 하는지 설명해 주세요
- __8.1.5 인터럽트 처리 시 고려해야 할 사항은 무엇인가요?
- 8.2 _ 시스템 콜
- __8.2.1 커널이란 무엇인가요?
- __8.2.2 유저 모드와 커널 모드를 나누는 이유는 무엇인가요?
- __8.2.3 시스템 콜이란 무엇인가요?
- __8.2.4 시스템 콜의 작동 과정을 설명해 주세요
- __8.2.5 시스템 콜 예시: 프로세스 관리
- 8.3 _ 핵심 용어 정리
- ▣ 09장: CPU 관리와 스케줄링
- 9.1 _ CPU 스케줄링
- __9.1.1 문맥 교환이란?
- __9.1.2 CPU 스케줄링이란?
- __9.1.3 프로세스 실행 흐름
- 9.2 _ 스케줄링 알고리즘
- __9.2.1 선입 선처리 스케줄링
- __9.2.2 최단 작업 우선 스케줄링
- __9.2.3 라운드 로빈 스케줄링
- 9.3 _ 핵심 용어 정리
- ▣ 10장: 메모리 관리
- 10.1 _ 메모리 계층 구조와 지역성
- __10.1.1 캐시의 작동 원리: 참조의 지역성
- __10.1.2 메모리 계층의 구성 요소
- 10.2 _ 가상 메모리와 주소 공간
- __10.2.1 가상 메모리의 개념과 필요성
- __10.2.2 가상 메모리가 왜 필요한지 설명해 주세요
- __10.2.3 주소 공간의 이해
- __10.2.4 주소 변환과 MMU: 가상 주소에서 물리 주소로 변환
- 10.3 _ 세그먼테이션과 페이징
- __10.3.1 세그먼테이션
- __10.3.2 페이징
- __10.3.3 세그먼테이션과 페이징 비교
- 10.4 _ 핵심 용어 정리
- [03부] 네트워크
- ▣ 11장: 네트워크 모델과 프로토콜
- 11.1 _ OSI 모델과 TCP/IP 모델의 차이점
- __11.1.1 OSI 모델은 무엇이며, 각 계층의 역할은 무엇인가요?
- __11.1.2 TCP/IP 모델은 어떻게 구성되어 있을까요?
- 11.2 _ TCP의 연결 및 해제 과정
- __11.2.1 TCP란?
- __11.2.2 UDP란?
- __11.2.3 TCP와 UDP는 어떻게 다르나요?
- __11.2.4 TCP의 연결은 어떻게 설정되나요? (3단계 핸드셰이크)
- __11.2.5 TCP의 연결은 어떻게 해제되나요? (4단계 핸드셰이크)
- 11.3 _ 핵심 용어 정리
- ▣ 12장: 인터넷 통신의 원리
- 12.1 _ DNS 개념과 작동 원리
- __12.1.1 DNS란?
- __12.1.2 DNS의 분산 계층 구조
- __12.1.3 DNS 작동 원리에 관해 설명해 주세요
- __12.1.4 DNS 캐싱이란?
- 12.2 _ 웹 통신의 흐름
- __12.2.1 URL과 URI의 차이점에 대해 설명해 주세요
- __12.2.2 브라우저에 www.google.com을 입력했을 때 일어나는 일에 관해 설명해 주세요
- 12.3 _ 웹 서버와 WAS
- __12.3.1 웹 서버란?
- __12.3.2 WAS란?
- __12.3.3 웹 서버와 WAS를 분리하는 이유에 대해 설명해 주세요
- 12.4 _ HTTP의 개념과 진화 과정
- __12.4.1 HTTP란?
- __12.4.2 HTTP 요청 메시지와 응답 메시지는 어떻게 구성되나요?
- __12.4.3 HTTP 메서드와 상태 코드
- __12.4.4 HTTP의 진화 과정
- 12.5 _ HTTPS
- __12.5.1 HTTPS란?
- __12.5.2 HTTP와 HTTPS의 차이점에 대해 설명해 주세요
- 12.6 _ 핵심 용어 정리
- ▣ 13장: 부하 분산
- 13.1 _ 프락시 서버
- __13.1.1 프락시 서버란?
- __13.1.2 왜 프락시 서버를 사용할까요?
- __13.1.3 프락시 서버의 종류
- 13.2 _ 로드 밸런싱
- __13.2.1 로드 밸런싱이란?
- __13.2.2 로드 밸런싱을 결정하는 기준
- __13.2.3 주요 로드 밸런싱 알고리즘
- __13.2.4 어떤 알고리즘을 선택해야 할까요?
- 13.3 _ 핵심 용어 정리
- ▣ 14장: 웹 보안과 정책
- 14.1 _ 쿠키와 세션
- __14.1.1 쿠키란?
- __14.1.2 세션이란?
- __14.1.3 쿠키와 세션의 차이점은?
- __14.1.4 보안 이슈와 해결책
- 14.2 _ SOP와 CORS
- __14.2.1 동일 출처 정책(SOP)이란?
- __14.2.2 SOP가 적용되는 사례와 한계
- __14.2.3 CORS란 무엇인가요?
- __14.2.4 CORS의 작동 방식과 주요 헤더
- __14.2.5 출처를 전부 허용하면 왜 문제가 되나요?
- __14.2.6 Preflight 캐시는 왜 길게 두면 위험한가요?
- 14.3 _ 핵심 용어 정리
- [04부] 데이터베이스
- ▣ 15장: 데이터베이스 기초
- 15.1 _ 관계형 데이터베이스란?
- __15.1.1 RDBMS는 어떻게 사용하나요?
- __15.1.2 사용자는 RDBMS에 어떻게 명령하나요?
- __15.1.3 RDBMS는 어떤 종류가 있나요?
- 15.2 _ 데이터 모델링
- __15.2.1 엔티티와 테이블
- __15.2.2 엔티티 연관관계와 엔티티-관계 다이어그램
- __15.2.3 무결성과 키
- 15.3 _ 정규화
- __15.3.1 데이터 중복으로 발생하는 이상 현상
- __15.3.2 함수 종속성
- __15.3.3 단계별 기본 정규형
- 15.4 _ 핵심 용어 정리
- ▣ 16장: 인덱스와 조인
- 16.1 _ 인덱스
- __16.1.1 인덱스의 자료구조
- __16.1.2 클러스터 인덱스와 비-클러스터 인덱스
- __16.1.3 인덱스는 어떻게 설정하고 내부적으로는 어떤 일이 일어날까요?
- 16.2 _ 조인
- __16.2.1 내부 조인 Inner Join
- __16.2.2 외부 조인 Outer Join
- __16.2.3 교차 조인 Cross Join
- __16.2.4 자가 조인 Self Join
- 16.3 _ 핵심 용어 정리
- ▣ 17장: 트랜잭션과 병행제어
- 17.1 _ 트랜잭션과 ACID 속성
- __17.1.1 커밋과 롤백
- __17.1.2 서로 다른 트랜잭션 간 상호작용
- __17.1.3 자동 커밋 Auto Commit
- __17.1.4 트랜잭션의 상태
- __17.1.5 ACID 속성
- __17.1.6 트랜잭션 스케줄
- 17.2 _ 이상 현상과 트랜잭션 격리 수준
- __17.2.1 Serializable
- __17.2.2 Repeatable read
- __17.2.3 Read committed
- __17.2.4 Read uncommitted
- __17.2.5 격리 수준별 허용하는 이상 현상
- __17.2.6 또 다른 이상 현상
- 17.3 _ 트랜잭션의 병행제어
- __17.3.1 공유잠금과 배타잠금
- __17.3.2 2PL(2-Phase Locking) 프로토콜
- __17.3.3 잠금으로 발생하는 교착상태
- 17.4 _ 핵심 용어 정리
이 책과 함께 읽으면 좋은 책
NEW
프런트엔드 성능 최적화 Deep Dive (ebook)
52,000원
중급
 코어 프런트엔드 UI (ebook)
30,400원
초급
 npm Deep Dive (ebook)
44,000원
중급
 문제풀이로 완성하는 알고리즘+자료구조 (ebook)
33,600원
중급