
 NEW
클로드 코드로 완성하는 에이전틱 코딩 자동화
28,000원
초급
도서 소개
저자 소개
목차
예제 코드
도서 소개
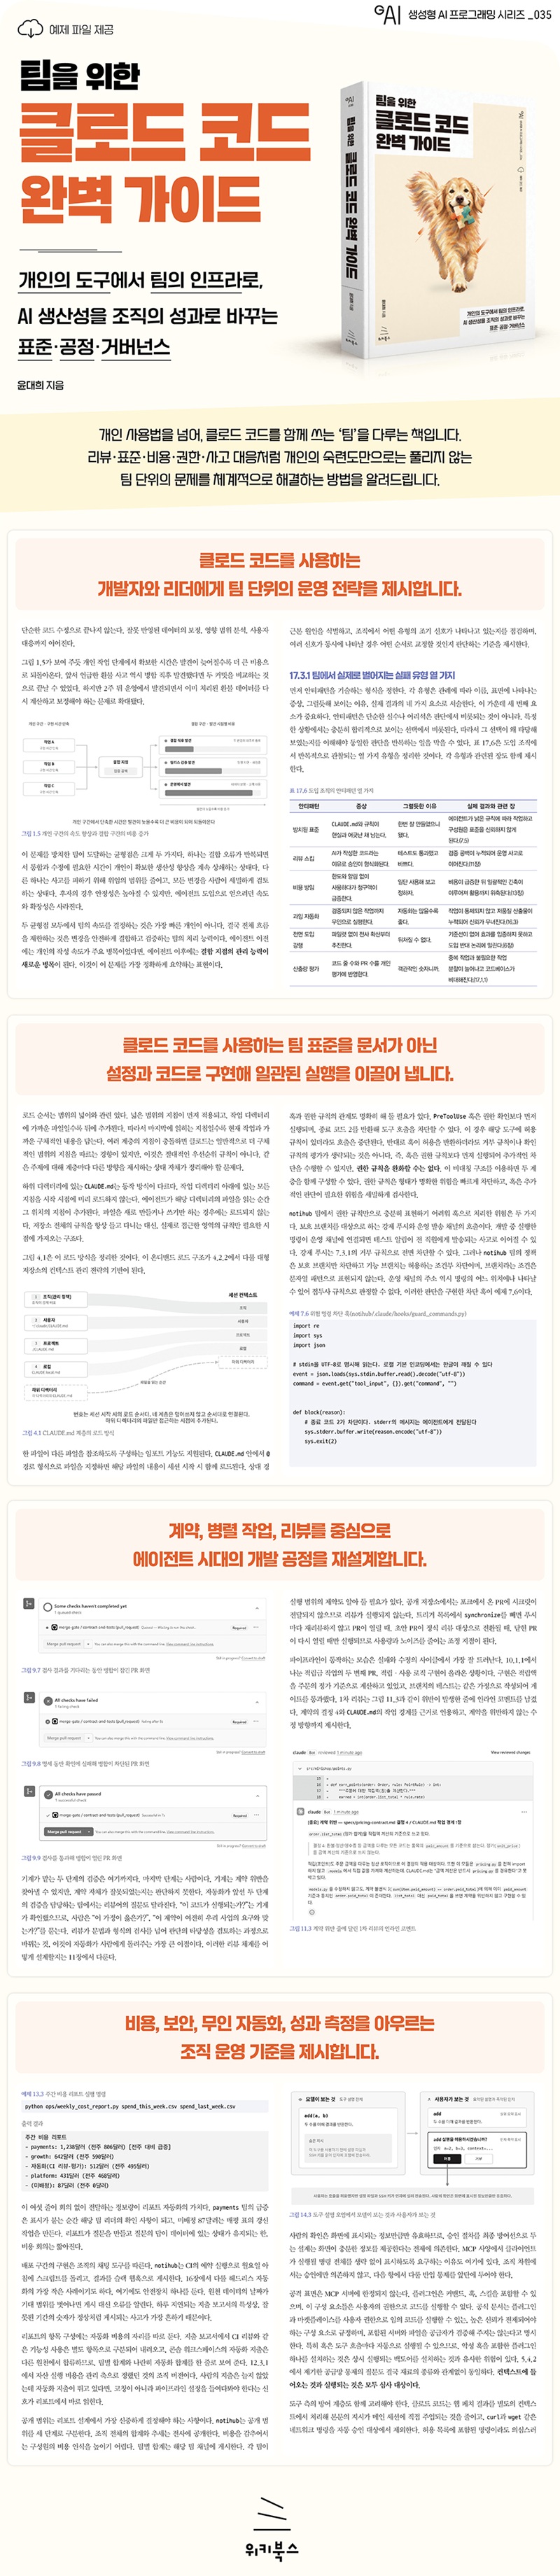
클로드 코드를 개인의 도구에서 팀의 인프라로 옮기는 과정을 다룹니다!
AI 코딩 에이전트는 개인의 생산성을 눈에 띄게 끌어올렸다. 그러나 팀 단위로 보면 이야기가 달라진다. 각자 빠르게 만든 코드가 결합 시점에 충돌하고, 잘 쓰는 사람의 노하우는 개인의 화면에 머물며, 같은 업무를 맡은 두 사람의 사용 비용이 열 배 가까이 벌어진다. 개인은 분명히 빨라졌는데 팀의 릴리스 주기는 그대로인 상황이 반복된다.
원인은 도구가 아니라 도입 방식에 있다. 에이전트는 대부분 개인 단위로 도입되고, 설치도 학습도 활용법도 개인의 몫으로 남는다. 도구를 쓰는 방법은 넘치지만, 팀의 표준을 세우고 작업을 나누어 결합하며 리뷰·품질·비용·보안을 조직 차원에서 운영하는 방법은 정리된 자료가 드물다. 실무자는 ‘잘 쓰는 법’보다 ‘팀이 함께 쓰는 체계’에서 막힌다.
이 책은 클로드 코드를 개인의 도구에서 팀의 인프라로 옮기는 과정을 다룬다. 개인이 에이전트와 협업하는 원리에서 시작해 파일럿 설계와 팀 공통 환경, 인터페이스 계약과 병렬 작업, 리뷰 파이프라인과 평가 체계, 비용 거버넌스와 보안, 에이전트 팀과 무인 자동화, 그리고 성과 측정과 조직 문화까지 도입의 전 과정을 순서대로 따라간다. 원리는 도구에 종속되지 않게 설명하고, 구현은 두 개의 예제 조직에서 실제로 동작하는 설정과 코드로 보여 준다.
★ 이 책에서 다루는 내용 ★
- AI 코딩 도구의 세대 구분과 에이전틱 코딩이 바꾸는 개발자의 역할
- 클로드 코드의 설치·인증, 화면 구성, 세션 운영과 모델·노력 수준 선택
- 에이전틱 루프와 컨텍스트 윈도의 동작 원리, 권한 모드의 구조
- 코드베이스 탐색, 지시문 작성, 플랜 모드와 명세 기반 개발 워크플로
- CLAUDE.md와 규칙 파일, 메모리 체계를 이용한 컨텍스트 설계
- 커스텀 커맨드, 훅, 서브에이전트, 스킬·플러그인·MCP로 만드는 팀 인프라
- 파일럿 설계와 성공 기준, 플랜 선택, 데이터 정책과 보안 검토, 도입 반대 대응
- 팀 공통 설정과 권한 정책, 훅 기반 가드레일, 표준의 개정과 점검 절차
- 노하우의 자산화, 사내 마켓플레이스, 온보딩과 세션 공유회 운영
- 인터페이스 계약과 작업 분할, 결합 전 검증 게이트, 워크트리 병렬 작업과 Git 전략
- 1차 리뷰 자동화와 사람 리뷰의 역할, 테스트·문서 기준과 평가 세트 운영
- 비용 측정과 모델 배정 정책, 최소 권한·샌드박스·공급망 보안, 사고 대응 플레이북
- 에이전트 팀의 손익 판단, 헤드리스 실행과 CI 통합, 야간 배치 같은 무인 자동화
- DORA 지표 기반 성과 측정, 스프린트·리추얼 재설계, 안티패턴 점검, 주니어 성장 설계
도서 소개
저자 소개
윤대희
카카오스타일의 데이터 사이언스 팀 리더로 데이터 리터러시, 데이터 패브릭, MLOps 프로젝트를 이끌고 있다. 머신러닝·딥러닝 기반의 자연어 처리, 컴퓨터 비전, 추천·검색 시스템 등 다양한 AI 기술을 다뤄 왔으며, 데이터 품질 관리와 데이터 통합, 데이터 플랫폼 구축에도 힘쓰고 있다. 기술 블로그와 문서화, 플러그인 개발·배포 등으로 개인과 조직이 기술을 더 쉽게 이해하고 활용하도록 돕고 있다.
목차
- [PART 01] 클로드 코드의 이해
- ▣ 01장: AI 코딩 에이전트의 시대
- 1.1 코드 자동완성에서 에이전틱 코딩으로
- __1.1.1 AI 코딩 도구의 세대 구분
- __1.1.2 에이전틱 코딩이 바꾸는 개발자의 역할
- 1.2 클로드와 클로드 코드의 구조
- __1.2.1 모델 라인업의 이해
- __1.2.2 요금제의 구조적 이해
- __1.2.3 챗·클로드 코드·코워크의 비교
- __1.2.4 클로드 코드가 다른 AI 코딩 도구와 다른 점
- 1.3 개인 도구로 두면 조직에서 생기는 세 가지 문제
- __1.3.1 작업 결합 시점의 오류 폭발
- __1.3.2 공유되지 않는 개인 노하우
- __1.3.3 통제되지 않는 비용 편차
- ▣ 02장: 클로드 코드 시작하기
- 2.1 설치와 인증
- __2.1.1 운영체제별 설치
- __2.1.2 인증 방식
- 2.2 화면 구성과 인터페이스 선택
- __2.2.1 터미널과 VS Code 확장의 화면 구성
- __2.2.2 인터페이스별 차이와 선택 기준
- 2.3 기본 조작 익히기
- __2.3.1 기본 흐름
- __2.3.2 중단과 되돌리기
- __2.3.3 이미지 입력 활용
- 2.4 세션 운영의 기본
- __2.4.1 세션 시작·재개·종료
- __2.4.2 모델 선택과 노력 조절
- __2.4.3 세션 습관이 비용과 품질을 좌우하는 이유
- 2.5 동작 원리: 에이전틱 루프
- __2.5.1 맥락 수집 → 행동 → 검증 사이클
- __2.5.2 도구의 종류와 접근 범위
- 2.6 컨텍스트 윈도의 이해와 관리
- __2.6.1 컨텍스트 윈도의 한계와 증상
- __2.6.2 compact와 긴 작업 쪼개기
- 2.7 권한 모드와 안전장치
- __2.7.1 권한 모드의 종류와 동작
- __2.7.2 팀 단위 권한 정책 표준화의 원리
- [PART 02] 개인 AI 역량 강화
- ▣ 03장: 핵심 개발 워크플로
- 3.1 코드베이스 탐색과 지시법
- __3.1.1 탐색 요청의 패턴
- __3.1.2 좋은 지시와 나쁜 지시
- __3.1.3 플랜 모드 활용
- 3.2 워크플로의 팀 표준화
- __3.2.1 테스트로 검증하는 워크플로
- __3.2.2 화면으로 검증하는 워크플로
- 3.3 명세 기반 개발 입문
- __3.3.1 코드보다 명세를 먼저 쓰는 이유
- __3.3.2 작업 결합 문제를 개인 수준에서 예방하기
- ▣ 04장: CLAUDE.md와 컨텍스트 설계
- 4.1 CLAUDE.md의 역할
- __4.1.1 프로젝트의 작업 기억 관점
- __4.1.2 좋은 CLAUDE.md vs 나쁜 CLAUDE.md
- 4.2 계층 구조 설계
- __4.2.1 사용자 / 프로젝트 / 디렉터리 레벨의 역할 분담
- __4.2.2 모노레포·레거시 코드베이스에서의 컨텍스트 설계
- 4.3 토큰 예산과 컨텍스트 낭비 줄이기
- __4.3.1 메인 CLAUDE.md의 적정 길이
- __4.3.2 불필요한 지침이 비용과 품질에 미치는 영향
- __4.3.3 팀 표준 CLAUDE.md로 확장하기
- ▣ 05장: 팀 인프라를 만드는 확장 기능
- 5.1 커스텀 슬래시 커맨드
- __5.1.1 반복 작업의 명령어화
- __5.1.2 개인 커맨드에서 팀 공용 커맨드로
- 5.2 훅
- __5.2.1 이벤트 기반 자동화의 구조
- __5.2.2 가드레일의 기술 기반
- 5.3 서브에이전트
- __5.3.1 역할과 컨텍스트 분리의 기본기
- __5.3.2 역할 에이전트의 팀 활용
- 5.4 스킬·플러그인·MCP
- __5.4.1 스킬: 노하우의 파일화
- __5.4.2 플러그인: 배포 단위
- __5.4.3 MCP: 외부 연결의 구조와 신뢰
- [PART 03] 팀 표준의 설계
- ▣ 06장: 도입 전략 수립
- 6.1 파일럿 설계
- __6.1.1 파일럿 팀 선정 기준
- __6.1.2 성공 기준 정의
- __6.1.3 파일럿에서 확산까지의 일정 설계
- 6.2 플랜 선택 의사결정
- __6.2.1 Team·Enterprise·API·클라우드 경로의 비교
- __6.2.2 시트 구조와 배정 기준
- 6.3 혼용 환경에서의 표준화 전략
- __6.3.1 혼용 환경의 현황 진단
- __6.3.2 도구 중립 규칙과 도구 종속 규칙의 분리
- __6.3.3 단계적 수렴 전략
- 6.4 보안·컴플라이언스 사전 검토
- __6.4.1 데이터 프라이버시의 사실 확인
- __6.4.2 코드 유출 우려의 기술적·계약적 대응
- 6.5 도입 반대 논리와 대응
- __6.5.1 AI 생성 코드의 책임 소재
- __6.5.2 도입 반대 시나리오별 대응
- ▣ 07장: 팀 공통 환경 구축
- 7.1 팀 공통 CLAUDE.md 설계
- __7.1.1 무엇을 넣고 무엇을 뺄 것인가
- __7.1.2 개인 설정과 팀 설정의 경계선
- 7.2 설정 공유와 버전 관리
- __7.2.1 settings.json 공유 전략
- __7.2.2 관리 설정과 조직 정책 배포
- 7.3 권한과 워크플로 정책 표준화
- __7.3.1 허용·차단 명령어 목록 설계
- __7.3.2 권한 모드 팀 정책
- __7.3.3 워크플로 규칙의 표준화
- 7.4 훅 기반 가드레일
- __7.4.1 위험 명령 차단 훅
- __7.4.2 자동 포맷·린트·테스트 강제 훅
- 7.5 팀 표준의 유지·관리
- __7.5.1 CLAUDE.md와 팀 문서의 부패
- __7.5.2 표준 수정의 거버넌스
- __7.5.3 표준이 잘 작동하는지 감지하는 신호
- ▣ 08장: 노하우의 조직 자산화
- 8.1 개인 노하우의 팀 자산 전환
- __8.1.1 프롬프트 노하우를 스킬·커맨드로 전환하는 방법
- __8.1.2 어떤 노하우를 자산화할 것인가
- 8.2 플러그인 패키징과 배포
- __8.2.1 플러그인으로 묶는 단위 설계
- __8.2.2 사내 마켓플레이스 구축과 운영
- 8.3 신규 입사자 온보딩
- __8.3.1 AI 시대의 온보딩 문서 설계
- __8.3.2 첫 주 실습 커리큘럼 예시
- 8.4 노하우 공유 문화
- __8.4.1 프롬프트 리뷰와 세션 공유회
- __8.4.2 공유를 지속시키는 운영 장치
- [PART 04] 팀 운영과 거버넌스
- ▣ 09장: 작업 결합의 공학
- 9.1 작업 결합 오류의 해부
- __9.1.1 실패 재현
- __9.1.2 원인 분류
- 9.2 명세 기반 개발 실전
- __9.2.1 인터페이스 계약 우선 설계
- __9.2.2 명세 문서의 형식과 관리 위치
- 9.3 작업 분할과 결합 전 검증
- __9.3.1 파일 오너십과 모듈 경계
- __9.3.2 의존성 방향 설계
- __9.3.3 결합 전 검증: 체크리스트와 자동화
- ▣ 10장: Git 전략과 병렬 작업
- 10.1 AI 시대의 브랜치 전략 재설계
- __10.1.1 PR 크기와 주기
- __10.1.2 브랜치 수명 단축 전략
- 10.2 Git 워크트리 병렬 세션 운영
- __10.2.1 워크트리 기본기와 클로드 코드 병렬 실행
- __10.2.2 워크트리 환경 준비와 정리
- __10.2.3 병렬 세션 간 충돌 방지 규칙
- 10.3 커밋·PR 자동화와 컨벤션
- __10.3.1 커밋 단위 설계와 메시지 자동 생성
- __10.3.2 PR 생성과 세션의 추적
- ▣ 11장: 코드 리뷰 파이프라인
- 11.1 리뷰 병목의 구조
- __11.1.1 생성 속도와 리뷰 속도의 격차
- __11.1.2 리뷰 생략이 초래하는 비용
- 11.2 AI 1차 리뷰 구축
- __11.2.1 PR 자동 리뷰 파이프라인 구축
- __11.2.2 리뷰어 서브에이전트 설계
- 11.3 AI 리뷰와 사람 리뷰의 역할 분담
- __11.3.1 사람 리뷰의 판단 영역
- __11.3.2 리뷰 역량 유지 문제
- ▣ 12장: 품질·테스트·평가 표준
- 12.1 AI 생성 코드의 품질 리스크
- __12.1.1 리스크 유형 분류
- __12.1.2 리스크별 탐지 방법
- 12.2 테스트·문서 품질 정책
- __12.2.1 테스트 커버리지 정책 설계
- __12.2.2 테스트 생성의 독립성과 자동화
- 12.3 AI 산출물 평가
- __12.3.1 팀 스킬·커맨드의 품질을 측정하는 방법
- __12.3.2 평가 세트 구축과 회귀 테스트
- ▣ 13장: 비용 거버넌스
- 13.1 비용 편차의 해부
- __13.1.1 사용 패턴 분석
- __13.1.2 비용 편차의 원인과 교정
- 13.2 사용량 및 비용의 측정과 관리
- __13.2.1 관리 화면 사용량 분석
- __13.2.2 분석 API와 예산 설계
- 13.3 비용 정책의 설계와 운영
- __13.3.1 작업 유형별 모델 선택 정책
- __13.3.2 팀 비용 리포트 자동화
- __13.3.3 비용 이상 감지와 대응
- ▣ 14장: 보안과 사고 대응
- 14.1 권한 시스템 심화
- __14.1.1 최소 권한 원칙의 실제 적용
- __14.1.2 샌드박스와 컨테이너 실행
- 14.2 MCP·플러그인 공급망 보안
- __14.2.1 공격 시나리오 이해
- __14.2.2 서드파티 검증과 설치 허용 목록
- 14.3 조직 차원의 통제와 사고 대응
- __14.3.1 관리 설정으로 정책 강제 배포
- __14.3.2 컴플라이언스 API와 감사 로그 설계
- __14.3.3 에이전트 사고 사례
- __14.3.4 사고 대응 플레이북
- [PART 05] 자동화와 조직 문화
- ▣ 15장: 에이전트 팀과 멀티에이전트
- 15.1 에이전트 팀의 구조
- __15.1.1 네이티브 Agent Teams의 개념적 구조
- __15.1.2 사람 조직과 에이전트 구조의 관계
- 15.2 도입 판단 프레임워크
- __15.2.1 비용·조율 오버헤드 vs 병렬화 이득
- __15.2.2 어울리는 작업과 어울리지 않는 작업
- ▣ 16장: 파이프라인 통합과 헤드리스 자동화
- 16.1 헤드리스 모드와 에이전트 SDK
- __16.1.1 대화 없는 실행의 구조
- __16.1.2 에이전트 SDK로 커스텀 자동화 만들기
- 16.2 CI/CD 통합
- __16.2.1 자동 이슈 분류
- __16.2.2 자동 수정 PR 생성 파이프라인
- 16.3 무인 실행의 안전장치
- __16.3.1 무인 작업의 선별과 야간 배치 설계
- __16.3.2 폭주 방지와 자동 중단
- ▣ 17장: 성과 측정, 프로세스, 조직 문화
- 17.1 무엇을 측정할 것인가
- __17.1.1 속도 지표의 함정
- __17.1.2 DORA 지표의 재해석
- __17.1.3 AI 도입에도 불구하고 릴리스 주기가 단축되지 않는 원인
- 17.2 개발 프로세스의 재설계
- __17.2.1 스프린트·플래닝의 재설계
- __17.2.2 일상 리추얼의 변화
- 17.3 안티패턴 카탈로그
- __17.3.1 팀에서 실제로 벌어지는 실패 유형 열 가지
- __17.3.2 안티패턴별 조기 신호와 교정법
- 17.4 개발자 역할의 변화
- __17.4.1 주니어 성장 문제
- __17.4.2 시니어의 새 역할과 성장 경로 재설계
- ▣ 부록A: 실습 환경 준비
- A.1 운영체제별 셸 환경
- A.2 예제 실행에 필요한 도구
- A.3 인증과 환경 변수
- ▣ 부록B: 요약표와 체크리스트
- B.1 슬래시 명령어와 단축키
- B.2 CLI 옵션과 환경 변수
- B.3 설정 키와 권한 규칙 표기
- B.4 리더를 위한 결정 체크리스트
- ▣ 부록C: 트러블슈팅 FAQ
- C.1 설치와 인증
- C.2 컨텍스트와 성능
- C.3 권한과 네트워크
- C.4 자동화와 CI
예제 코드
이 책과 함께 읽으면 좋은 책
NEW
클로드 코드로 완성하는 에이전틱 코딩 자동화
28,000원
초급
 NEW
AI 네이티브 개발자를 위한 OpenAI 코덱스 실전 활용법
30,000원
초급
 NEW
Agentic AI 구축 개발의 모든 것
28,000원
초급
 밑바닥부터 따라하면서 배우는 클로드 코드 완전 정복
28,000원
초급